La adopción de modelos de inteligencia artificial entrenados con datos corporativos propios representa una ventaja competitiva significativa para las organizaciones, pero también introduce una superficie de ataque completamente nueva. A medida que las empresas españolas desarrollan capacidades de machine learning utilizando información sensible —desde bases de datos de clientes hasta propiedad intelectual— se enfrentan a riesgos de seguridad que van mucho más allá de las vulnerabilidades tradicionales. El entrenamiento de modelos de IA con datos corporativos crea vectores de amenaza únicos que requieren estrategias de protección específicas y una comprensión profunda de cómo los atacantes pueden explotar estos sistemas.
Los modelos de IA entrenados con datos corporativos enfrentan riesgos críticos como exfiltración de datos sensibles mediante ataques de inversión de modelo, envenenamiento de datos durante el entrenamiento, exposición inadvertida de información confidencial en respuestas del modelo, y vulnerabilidades en la cadena de suministro del pipeline de ML. Las organizaciones deben implementar controles de seguridad específicos incluyendo anonimización robusta de datos de entrenamiento, monitorización continua de comportamientos anómalos del modelo, segmentación de entornos de desarrollo, y auditorías de privacidad diferencial para proteger sus activos más valiosos.
Vectores de riesgo específicos en modelos de IA corporativos
El entrenamiento de modelos con datos corporativos introduce vectores de ataque que no existen en sistemas tradicionales. El primer riesgo crítico es la exfiltración de datos mediante ataques de inversión de modelo, donde adversarios pueden extraer información del conjunto de entrenamiento realizando consultas diseñadas específicamente. Investigaciones recientes han demostrado que modelos de lenguaje natural pueden memorizar y posteriormente revelar información sensible como números de tarjetas de crédito, datos personales o secretos comerciales presentes en los datos de entrenamiento.
El envenenamiento de datos representa otro vector crítico. Los atacantes que comprometen el pipeline de ingesta de datos pueden inyectar información maliciosa que corrompe el comportamiento del modelo. Este tipo de ataque es particularmente insidioso porque puede permanecer latente durante meses, activándose solo bajo condiciones específicas. En entornos corporativos donde los modelos se reentrenan continuamente con nuevos datos, una única fuente comprometida puede contaminar generaciones sucesivas del modelo.
La inferencia de membresía permite a los atacantes determinar si datos específicos formaron parte del conjunto de entrenamiento, lo que puede revelar información corporativa sensible sobre clientes, transacciones o relaciones comerciales. Un atacante podría, por ejemplo, confirmar si una empresa específica es cliente de la organización simplemente observando cómo el modelo responde a consultas relacionadas.
Los ataques adversarios en tiempo de inferencia explotan vulnerabilidades del modelo ya desplegado mediante entradas diseñadas para provocar comportamientos no deseados o extraer información. Técnicas como prompt injection pueden manipular modelos de lenguaje para que ignoren restricciones de seguridad y revelen datos confidenciales que no deberían ser accesibles.
Controles de seguridad esenciales para proteger modelos corporativos
La protección efectiva de modelos de IA corporativos requiere implementar controles específicos en cada fase del ciclo de vida del machine learning. Durante la fase de preparación de datos, es fundamental aplicar técnicas robustas de anonimización y pseudonimización que vayan más allá del simple enmascaramiento. La privacidad diferencial debe aplicarse desde el diseño, agregando ruido estadístico controlado que protege información individual sin degradar significativamente el rendimiento del modelo.
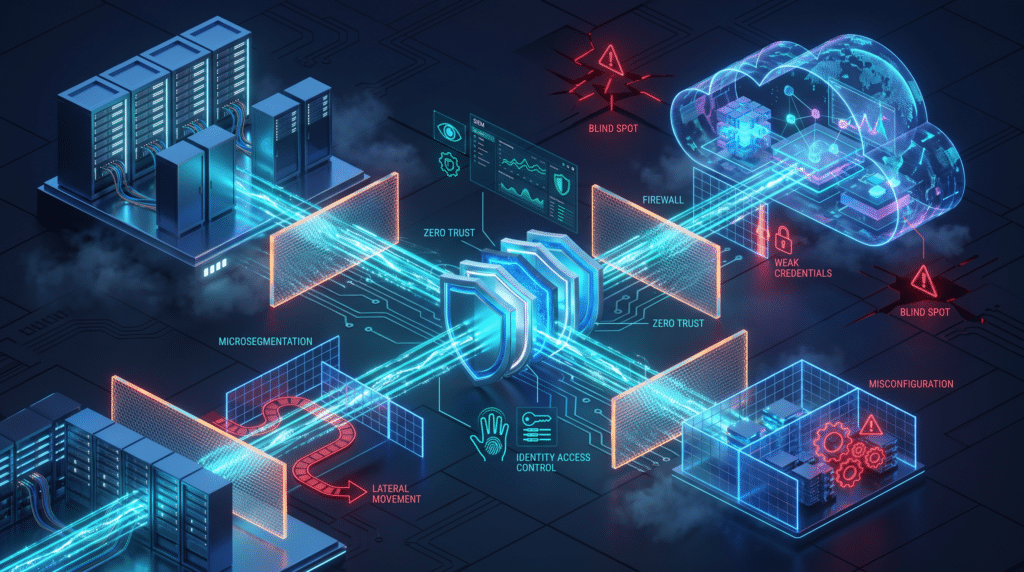
La segmentación estricta de entornos es crítica: los datos de producción nunca deben utilizarse directamente en entornos de desarrollo o experimentación. Implementar sandboxes aislados con datos sintéticos o anonimizados para el desarrollo inicial reduce dramáticamente la superficie de exposición. Los entornos de entrenamiento deben tener controles de acceso rigurosos con autenticación multifactor y registro exhaustivo de todas las interacciones con datos sensibles.
La monitorización continua del comportamiento del modelo permite detectar anomalías que podrían indicar compromisos. Esto incluye analizar patrones de consulta inusuales, desviaciones estadísticas en las salidas del modelo, y cambios no autorizados en los parámetros. Herramientas de MLOps con capacidades de seguridad integradas deben registrar todas las versiones del modelo, conjuntos de datos utilizados, y cambios en hiperparámetros para mantener una cadena de custodia completa.
Las auditorías de seguridad específicas para IA deben incluir pruebas de extracción de información mediante ataques de inversión, evaluaciones de robustez frente a entradas adversarias, y análisis de qué información puede inferirse del modelo. Red teams especializados en IA deben intentar explotar el modelo utilizando técnicas conocidas de ataque antes del despliegue en producción.
| Vector de Riesgo | Impacto Potencial | Control Recomendado | Prioridad |
|---|---|---|---|
| Inversión de modelo | Exfiltración de datos de entrenamiento | Privacidad diferencial + rate limiting | Crítica |
| Envenenamiento de datos | Corrupción del modelo | Validación de fuentes + detección de anomalías | Crítica |
| Inferencia de membresía | Revelación de relaciones comerciales | Agregación estadística + anonimización | Alta |
| Prompt injection | Bypass de controles de acceso | Sanitización de entradas + filtros contextuales | Alta |
| Compromiso de dependencias | Backdoors en el pipeline ML | Análisis de supply chain + firmas criptográficas | Media |
La gobernanza de modelos debe establecer políticas claras sobre qué tipos de datos pueden utilizarse para entrenar modelos, quién tiene autorización para acceder a datos sensibles durante el desarrollo, y qué aprobaciones se requieren antes de desplegar modelos en producción. Un comité de ética y seguridad de IA debería revisar proyectos de alto riesgo que involucren datos personales, información financiera o propiedad intelectual crítica.
La encriptación de modelos en reposo y en tránsito protege contra accesos no autorizados, mientras que técnicas de computación confidencial permiten ejecutar inferencias sobre datos encriptados sin exponerlos. Para organizaciones con requisitos regulatorios estrictos, el aprendizaje federado permite entrenar modelos distribuidos sin centralizar datos sensibles, aunque introduce complejidades operacionales adicionales.
Finalmente, es fundamental mantener un inventario completo de modelos desplegados, incluyendo qué datos se utilizaron para entrenamiento, qué información podría potencialmente extraerse, y qué controles de seguridad están implementados. Este inventario debe actualizarse con cada reentrenamiento o modificación del modelo, manteniendo registros auditables que cumplan con requisitos de GDPR y otras regulaciones de protección de datos aplicables en España.
¿Desarrolla su organización modelos de IA con datos corporativos?
Nuestro equipo especializado en seguridad de IA puede evaluar los riesgos de sus proyectos de machine learning y diseñar controles específicos para proteger su información más sensible.